레퍼런스 릴스에서 내 나레이션 목소리 찾아내기 — 감이 아니라 숫자로
마음에 든 레퍼런스 영상의 나레이션과 같은 결의 목소리를 고르는 법. 넘겨짚었다가 틀린 뒤, 오디오를 받아 기본 주파수(F0)를 재서 후보 음성과 대조했다. 155.2Hz 대 161.2Hz.
🗺 시리즈: 네이버 클립 자동 제작 — 지금은 ③ 레퍼런스에서 내 나레이션 목소리 찾기
← 이전 편: ② 한 글자씩 찍히는 타이핑 자막
① 컷시트 렌더 엔진 · ② 한 글자씩 찍히는 타이핑 자막 · ③ 레퍼런스에서 내 나레이션 목소리 찾기 (현재 글) · ④ 컷 길이를 말에 맞추기
자막까지 만든 영상에 나레이션을 붙일 차례였다. “예전에 만든 그 클립이랑 같은 느낌으로 해줘”가 요구사항이었다.
이 글은 그걸 넘겨짚었다가 틀린 뒤, 숫자로 다시 찾아낸 기록이다.
이 글에서 찾아낸 목소리로 21문장을 읽힌 결과물
문제
레퍼런스로 받은 건 링크 하나였다. 클립 하나가 열리고, 거기에 나레이션이 깔려 있다.
여기서 첫 번째 실수를 했다. “네이버 클립 앱 내장 AI 보이스일 겁니다” 라고 단정하고, 그러니 똑같이는 못 만든다고 답했다. 그럴듯했다. 클립 앱에 음성 기능이 있고, 블로그 클립이니 그걸 썼겠거니 했다.
돌아온 답은 짧았다.
네이버 클립 앱 내장 AI 보이스 아닌데?
근거 없이 단정한 것이었다. 확인한 게 아니라 그럴듯해서 그렇게 말했다. 게다가 나는 그 사이 여성 음성으로 나레이션을 다 만들어 넘긴 상태였다.
원인
문제의 뿌리는 “비슷한 목소리”를 귀로만 판단하려 했다는 데 있다.
목소리가 비슷한지는 주관적인 판단처럼 느껴지지만, 실제로는 잴 수 있는 물리량이 있다. 기본 주파수(F0) — 성대가 진동하는 속도다. 남성은 대개 100~150Hz, 여성은 200~250Hz 근처에 있다. 이걸 재면 “남자 목소리인가 여자 목소리인가”부터 “얼마나 낮은가”까지 숫자로 나온다.
재지 않고 고르니 틀렸다. 재면 될 일이었다.
해결 과정
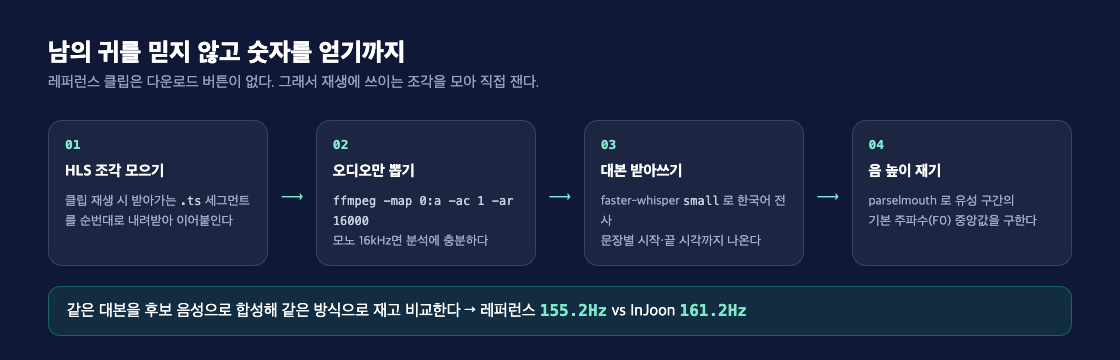 레퍼런스 클립은 다운로드 버튼이 없다. 재생에 쓰이는 조각을 모아 직접 잰다.
1. 레퍼런스 오디오 확보하기
클립 페이지에는 다운로드가 없다. 대신 재생하려면 어차피 브라우저가 영상 조각을 받아간다. 개발자도구 네트워크 탭에 HLS 세그먼트(.ts)가 순번대로 찍힌다.
같은 URL 패턴에서 번호만 올려가며 받아 이어붙였다.
1
2
3
4
5
6
for i in $(seq -w 0 30); do
  n=$(printf "%06d" $((10#$i)))
  code=$(curl -s -o "seg$n.ts" -w "%{http_code}" "$BASE-$n.ts?$TOKEN")
  [ "$code" != "200" ] && { rm -f "seg$n.ts"; break; }
done
cat seg*.ts > all.ts
세그먼트 URL에는 만료 시각이 담긴 서명 토큰이 붙어 있다. 네트워크 탭에서 복사한 그 토큰째로 받아야 한다.
오디오만 모노 16kHz로 뽑았다. 분석에는 그 이상이 필요 없다.
1
ffmpeg -y -v error -i all.ts -map 0:a:0 -ac 1 -ar 16000 ref.wav
2. 대본 받아쓰기
목소리를 비교하려면 같은 문장을 후보 음성으로도 합성해야 공정하다. 그래서 레퍼런스가 뭐라고 말하는지부터 받아썼다.
1
2
3
4
5
from faster_whisper import WhisperModel
m = WhisperModel("small", device="cpu", compute_type="int8")
segs, info = m.transcribe("ref/ref.wav", language="ko", vad_filter=False)
for s in segs:
    print(f"{s.start:5.2f}–{s.end:5.2f}  {s.text.strip()}")
1
2
3
4
5
 0.00– 3.60  올해를 끝으로 문을 닫는 포천 블루파크에 다녀왔어요.
 3.60– 6.80  저희는 유아풀 옆 수박텐트를 이용했어요.
 6.80–10.50  평상, 블루존, 단체석 등 다양하게 있어요.
…
24.00–26.40  여름 휴가로 포천 블루파크 추천합니다.
문장별 시작·끝 시각까지 나온다. 이게 뒤에서 문장 단위 비교에 그대로 쓰인다.
3. 음 높이 재기
parselmouth(Praat의 파이썬 바인딩)로 유성 구간의 F0 중앙값을 구한다. 무성음(ㅅ, ㅎ 같은)은 주파수가 0으로 나오므로 걸러낸다.
1
2
3
4
5
6
7
import parselmouth, numpy as np

def f0(path):
    s = parselmouth.Sound(path)
    v = s.to_pitch(0.01, 75, 500).selected_array['frequency']
    v = v[v > 0]                       # 유성 구간만
    return np.median(v), np.percentile(v, 10), np.percentile(v, 90)
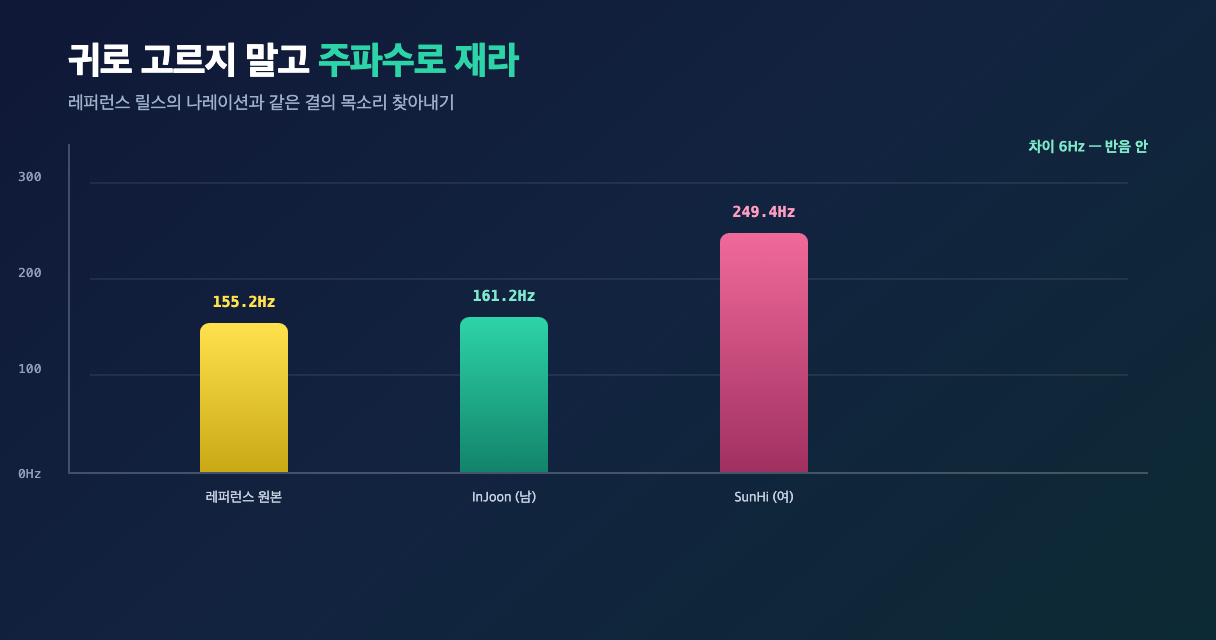
레퍼런스를 재보니 중앙값 155.2Hz. 남성 음성이었다. 내가 쓴 여성 음성(SunHi)은 249.4Hz였다. 거의 한 옥타브 차이다.
4. 후보와 대조하기
이제 같은 대본을 후보 음성으로 합성해 같은 방식으로 잰다. 한국어 뉴럴 음성 세 종을 놓고 문장별로 비교했다.
| 레퍼런스 문장 | 원본 F0 | InJoon(남) | Hyunsu(남) | SunHi(여) |
|---|---|---|---|---|
| 올해를 끝으로 문을 닫는… | 158.7 | 166 | 139 | 252 |
| 저희는 유아풀 옆… | 162.5 | 161 | 141 | 244 |
| 평상, 블루존, 단체석… | 145.8 | 148 | 129 | 216 |
| 아이들 모두 신나게 놀았어요 | 131.4 | 151 | 135 | 216 |
| 여름 휴가로 포천 블루파크 추천합니다 | 176.9 | 175 | 147 | 269 |
InJoon이 다섯 문장 모두에서 따라붙는다. 길이도 첫 문장 기준 3.60초 대 3.62초로 거의 같았다.
확인 사살로 레퍼런스 전체 대본을 InJoon으로 통째로 합성해 재봤다.
| 중앙 F0 | 10~90% 구간 | |
|---|---|---|
| 레퍼런스 원본 | 155.2Hz | 104~196 |
| 같은 대본 → InJoon | 161.2Hz | 103~214 |
| 같은 대본 → SunHi | 249.4Hz | 166~311 |
6Hz 차이, 반음도 안 된다. 여기서 음성을 확정했다.
이건 “레퍼런스가 InJoon으로 만들어졌다”는 증명이 아니다. 원 도구가 무엇인지는 확인 불가다. 음향 특성이 반음 안에서 일치한다는 것까지가 근거가 지지하는 범위다.
함정 — 내 영상의 F0는 178Hz로 나왔다
음성을 바꿔 나레이션을 다시 만들고 재봤더니 177.9Hz가 나왔다. 레퍼런스 155.2Hz보다 한참 높다. 잘못 골랐나 싶었다.
아니었다. 문장 내용이 다르기 때문이다. 내 자막은 소방 테마존이 있고, 카운터가 먼저 나오고처럼 끝이 올라가는 연결어미가 많다. 레퍼런스는 ~다녀왔어요, ~추천합니다로 끝나는 긴 평서문이라 문장 끝에서 음이 떨어진다.
그래서 비교는 반드시 같은 대본으로 해야 한다. 다른 문장끼리 F0를 비교하면 목소리가 아니라 억양을 비교하게 된다. 위에서 “같은 대본으로 다시 합성해” 확인한 이유가 이것이다.
나레이션 붙이기
음성이 정해진 뒤 실제 작업은 단순했다. 컷시트의 자막을 문장 단위로 합성해 각 컷 시작 시각에 배치한다.
1
edge-tts --voice ko-KR-InJoonNeural --rate="+35%" --text "$TXT" --write-media "_s.mp3"
두 가지를 손봐야 했다.
합성음 앞뒤 무음 제거. 그대로 쓰면 자막이 뜬 뒤에 목소리가 늦게 나온다.
1
2
-af "silenceremove=start_periods=1:start_silence=0.02:start_threshold=-45dB:detection=peak,\
areverse,silenceremove=start_periods=1:start_silence=0.02:start_threshold=-45dB:detection=peak,areverse"
이 단계에서 합친 소리가 뒤로 갈수록 커진다면 → ffmpeg amix로 합쳤더니 뒤로 갈수록 소리가 커진다
컷을 넘치면 속도를 올린다. 다만 +55%를 상한으로 뒀다. 그 이상은 사람 말이 아니라 배속 재생으로 들린다. (컷 길이 자체를 문장에 맞추는 이야기는 다음 편에서 다룬다.)
🧭 기획자·사업자라면 “비슷하게 해주세요”는 요구사항이 아니다. 무엇이 비슷해야 하는지 — 성별인지, 높이인지, 속도인지, 억양인지 — 를 잴 수 있는 값으로 바꿔야 검수가 가능해진다. 이 건에서는 F0 하나로 남녀 오판을 걸러냈고, 발화 속도(초당 음절)로 페이스를 맞췄다. 그리고 AI가 그럴듯하게 단정하는 지점을 알아둬야 한다. “앱 내장 음성일 겁니다”는 확인 없이 나온 말이었고, 그 위에서 작업이 한 바퀴 헛돌았다. 산출물에 근거를 함께 요구하면 이런 손실을 앞에서 막을 수 있다. 이 글의 표들이 그 근거다.
사용한 기술
- HLS(
.ts) 세그먼트 수집 — 재생에 쓰이는 조각을 순번대로 받아 이어붙인다. 서명 토큰째로 요청해야 한다 - faster-whisper — 한국어 전사.
small+int8이면 CPU에서도 실용적이다 - praat-parselmouth — 유성 구간의 F0 중앙값·분위수 추출
- edge-tts — 한국어 뉴럴 음성 3종(
InJoon·SunHi·HyunsuMultilingual). ⚠️ 문장을 외부 서버로 보내 합성한다 - ffmpeg
silenceremove— 합성음 앞뒤 무음 잘라내기
정리
- “비슷한 목소리”는 잴 수 있다. F0 중앙값 하나로 남녀 오판이 바로 걸러진다. 귀로 고르기 전에 재라.
- 비교는 같은 대본으로. 문장이 다르면 목소리가 아니라 억양을 비교하게 된다. 내 영상이 178Hz로 나온 건 목소리가 아니라 어미 탓이었다.
- 근거 없이 단정한 한 문장이 작업 한 바퀴를 헛돌게 했다. “앱 내장 음성일 겁니다”에 근거가 없었고, 그 위에서 만든 나레이션은 전부 다시 만들어야 했다.
다음 편에서는 이 나레이션이 배속 재생처럼 빨라지던 문제를 다룬다. 컷 길이를 사람이 어림하지 않고, 문장을 실제로 합성해 재서 역산하는 이야기다.