숏폼 자막이 한 글자씩 찍히게 만들기 — 글자가 좌우로 흔들리지 않으려면
릴스·쇼츠 자막이 타이핑되듯 나타나게 만들려면 글자가 늘 때마다 문장이 좌우로 출렁이는 문제부터 풀어야 한다. ffmpeg drawtext만으로, 완성 문장의 왼쪽 x를 픽셀로 재서 고정하는 방법.
🗺 시리즈: 네이버 클립 자동 제작 — 지금은 ② 한 글자씩 찍히는 타이핑 자막
← 이전 편: ① 컷시트 렌더 엔진
① 컷시트 렌더 엔진 · ② 한 글자씩 찍히는 타이핑 자막 (현재 글) · ③ 레퍼런스에서 내 나레이션 목소리 찾기 · ④ 컷 길이를 말에 맞추기
지난 편에서 컷시트를 넣으면 세로 영상이 나오는 렌더 엔진을 만들었다. 이번엔 그 자막이 한 글자씩 찍히게 한다. 외부 라이브러리 없이 ffmpeg drawtext만 쓴다.
이 글의 방식으로 자막을 넣은 클립 — 21개 문장이 전부 한 글자씩 찍힌다
문제
숏폼에서 자막이 한 번에 툭 나타나는 것과, 타이핑되듯 한 글자씩 찍히는 것은 체감이 꽤 다르다. 후자가 시선을 붙잡는다.
원리는 단순해 보였다. 문장의 앞부분만 잘라낸 조각을 여러 개 만들고, 시간대별로 하나씩 보여주면 된다.
1
2
3
4
5
6
비
비 오
비 오면
비 오면 여
…
비 오면 여기로 가세요
drawtext에 enable='between(t,a,b)'를 붙이면 특정 시간 구간에만 그려지니, 조각마다 시간 창을 나눠주면 끝이다. 그렇게 만들었더니 문장이 좌우로 출렁였다.
원인
자막은 화면 가운데 정렬이다.
1
drawtext=...:x=(w-text_w)/2
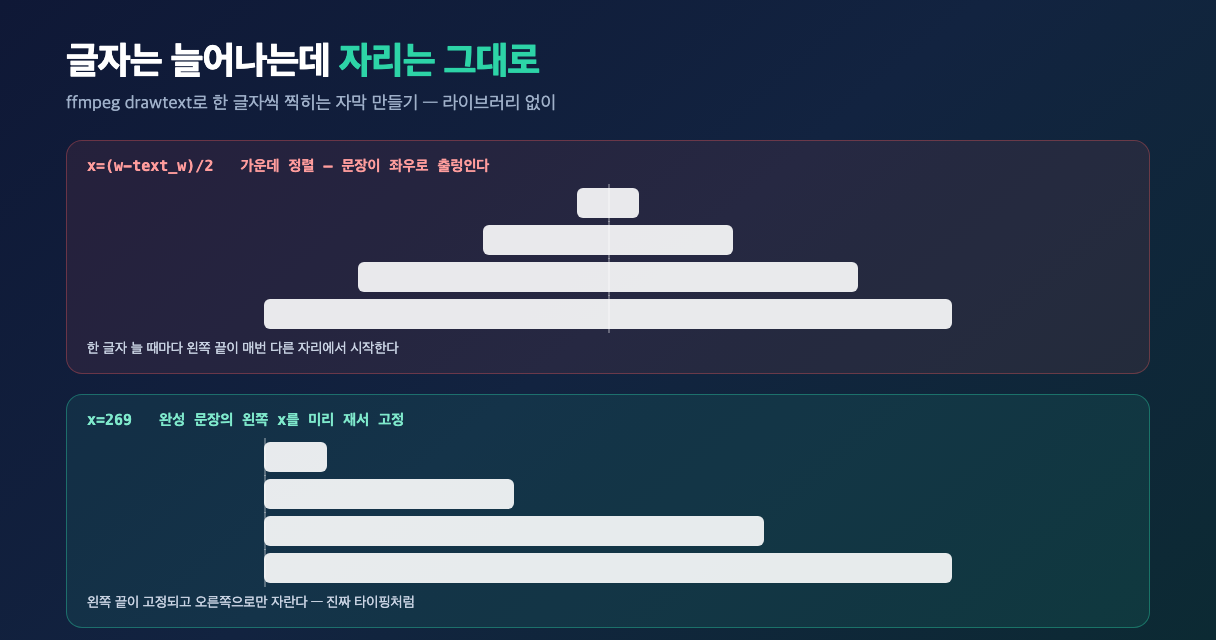
text_w는 그 drawtext가 그리는 글자의 폭이다. 조각마다 글자 수가 다르니 text_w도 다르고, 따라서 시작 x가 매번 달라진다. 비 한 글자일 때는 화면 정중앙에서 시작하고, 문장이 완성될 즈음엔 훨씬 왼쪽에서 시작한다.
타이핑처럼 보이려면 왼쪽 끝이 고정되고 오른쪽으로만 자라야 한다. 그러려면 각 조각을 그릴 때 완성된 문장의 왼쪽 x를 알아야 하는데, 여기서 막힌다.
drawtext표현식은 자기 자신의text_w만 참조할 수 있다. 다른 drawtext의 폭이나, 아직 그리지 않은 문장의 폭을 가져올 방법이 필터그래프 안에는 없다.
해결 과정
실패한 시도 — cropdetect로 글자 상자를 재보려 했다
먼저 떠오른 건 cropdetect였다. 검은 캔버스에 흰 글씨를 그린 뒤 잉크가 차지하는 사각형을 잡아주면 그 왼쪽이 곧 x다.
1
ffmpeg -i m.png -vf "cropdetect=limit=16:round=2:reset=1" -frames:v 1 -f null -
아무것도 출력되지 않았다. -v info로 올려도, metadata=mode=print:file=-를 붙여도, ffprobe로 frame_tags를 읽어도 마찬가지였다. lavfi로 감싸 -show_frames까지 가보니 값은 나오는데 전부 0이었다.
1
2
frames.frame.0.crop_left=0
frames.frame.0.crop_right=0
단일 프레임에서는 cropdetect가 제대로 동작하지 않는 것으로 보였다. 여기에 더 시간을 쓰지 않고 방향을 바꿨다.
열 평균 밝기로 재기
cropdetect가 하려던 일을 직접 하기로 했다. 글자를 1픽셀 높이로 눌러버리면, 각 열이 그 열의 평균 밝기가 된다. 검은 배경에 흰 글씨니까 밝기가 0이 아닌 첫 열이 곧 글자의 왼쪽 끝이다.
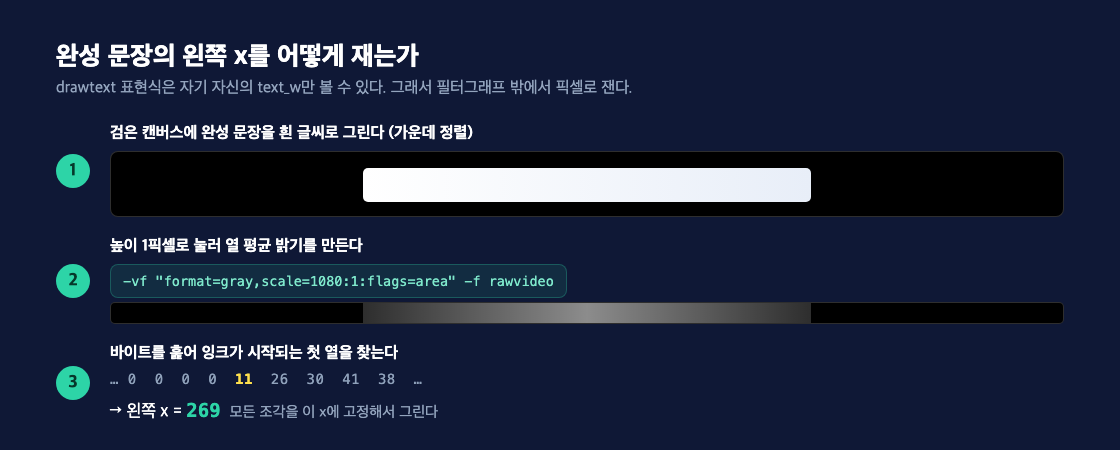 필터그래프 안에서 못 구하는 값을, 한 번 렌더해서 픽셀로 잰다.
1
2
3
4
5
6
7
8
9
10
text_x0() { # $1 textfile  $2 fontsize
  # 1) 검은 캔버스에 완성 문장을 가운데 정렬로 그린다
  ffmpeg -y -v error -f lavfi -i "color=c=black:s=1080x240" \
    -vf "drawtext=fontfile=font.ttf:textfile=$1:fontcolor=white:fontsize=$2:x=(w-text_w)/2:y=60" \
    -frames:v 1 -pix_fmt gray "_m.png"
  # 2) 높이 1픽셀로 눌러 열 평균 밝기를 만든 뒤 3) 밝은 첫 열을 찾는다
  ffmpeg -v error -i _m.png -vf "format=gray,scale=1080:1:flags=area" \
    -frames:v 1 -f rawvideo - 2>/dev/null \
    | od -An -tu1 -v | tr -s ' ' '\n' | grep -n . | awk -F: '$2+0>2 {print $1-1; exit}'
}
flags=area가 중요하다. 기본 보간으로 줄이면 얇은 획이 샘플링에서 통째로 빠질 수 있는데, 면적 평균은 그 열에 잉크가 조금이라도 있으면 값이 남는다. 임계값을 >2로 둔 것도 압축·안티에일리어싱 노이즈를 걸러내기 위해서다.
외부 라이브러리가 필요 없다. ffmpeg과 셸 기본 도구만으로 폰트 메트릭을 얻은 셈이다.
한글을 글자 단위로 자르기
조각을 만들려면 문장을 한 글자씩 잘라야 하는데, 여기서 또 걸렸다. macOS 기본 awk의 substr은 바이트 기준이라 한글을 자르면 글자가 깨진다. cut -c, fold -w1도 로케일에 따라 결과가 달라진다.
perl을 썼다. -CS가 표준입출력을 UTF-8로 처리한다.
1
printf '%s' "$txt" | perl -CS -ne "chomp; print substr(\$_,0,$i)"
주의할 점 하나. 셸 안에서 문자열 리터럴로 넘기면 인코딩이 깨진다. 반드시 표준입력으로 넣어야 한다.
1
2
3
4
5
# ✗ 깨진다 — perl이 소스를 UTF-8로 해석하지 않는다
perl -CS -e 'my $s="비 오면"; print substr($s,0,2)'   # ë¹ ...

# ✓ 정상
printf '%s' "비 오면" | perl -CS -ne 'chomp; print substr($_,0,2)'
조각을 시간에 배치하기
이제 조각마다 drawtext를 하나씩 만들고, 앞서 잰 x0에 고정한다.
1
2
3
4
5
6
7
8
9
10
span=$(awk "BEGIN{s=0.9; h=($t1-$t0)*0.5; if(s>h)s=h; print s}")   # 타이핑 시간
i=1
while [ "$i" -le "$n" ]; do
  printf '%s' "$txt" | perl -CS -ne "chomp; print substr(\$_,0,$i)" > "txt/p${i}.txt"
  a=$(awk "BEGIN{printf \"%.3f\", $t0+($i-1)*$span/$n}")
  if [ "$i" -lt "$n" ]; then b=$(awk "BEGIN{printf \"%.3f\", $t0+$i*$span/$n}"); else b="$t1"; fi
  out="${out},drawtext=fontfile=font.ttf:textfile=txt/p${i}.txt:fontcolor=white:fontsize=${fsz}\
:borderw=6:bordercolor=black@0.8:x=${x0}:y=${y}:enable='between(t,${a},${b})'"
  i=$((i+1))
done
두 가지를 정해뒀다.
- 타이핑은 0.9초 안에 끝낸다. 더 길면 읽기 답답하다.
- 컷 길이의 절반을 넘지 않는다. 2초짜리 컷이면 1초 안에 끝나야 남은 시간에 문장을 읽을 수 있다.
- 마지막 조각은 컷이 끝날 때까지 남긴다.
b를t1으로 주는 이유다.
문장 하나에 10~15개의 drawtext가 붙고, 22컷 전체로는 250개쯤 쌓인다. 렌더 시간은 눈에 띄게 늘지 않았다.
결과
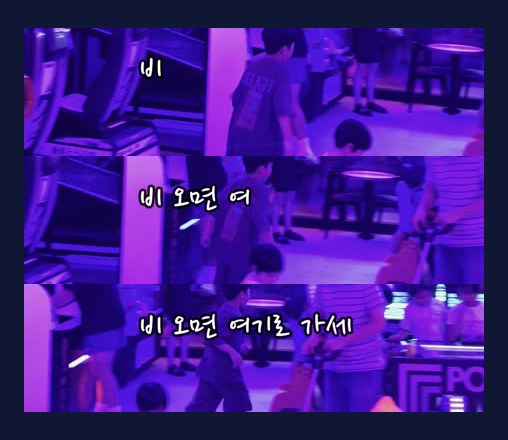 같은 컷의 1.9초 · 2.2초 · 2.6초. 글자는 늘어나는데 왼쪽 끝은 그대로다.
괄호 부연 자막은 본자막이 다 찍힌 0.9초 뒤부터 이어서 찍히게 했다. 동시에 나오면 어느 걸 읽어야 할지 모르게 된다.
덤 — 손글씨 폰트에 가운뎃점이 없었다
타이핑을 붙이면서 자막 폰트를 나눔손글씨 펜으로 바꿨는데, 상단 배지가 이렇게 렌더됐다.
1
강원 속초    비 오는 날      ← 가운뎃점 자리가 빈칸
폰트의 문자표를 열어보니 원인이 나왔다.
1
2
3
4
5
6
7
8
from fontTools.ttLib import TTFont
t = TTFont('NanumPenScript-Regular.ttf'); cm = t.getBestCmap()
for c in (0x00B7, 0x30FB, 0x2022, 0x002C):
    print(hex(c), chr(c), c in cm)
# 0xb7  ·  False
# 0x30fb ・ False
# 0x2022 • False
# 0x2c   ,  True
가운뎃점(U+00B7)도, 그 대체 문자들도 전부 없다. 쉼표로 바꿔 해결했다. 손글씨·장식 폰트로 바꿀 때는 쓰려는 기호가 폰트에 있는지 먼저 확인해야 한다. drawtext는 없는 글자를 조용히 빈칸으로 그린다.
🧭 기획자·사업자라면 “라이브러리가 없다”가 “못 한다”는 아니다. 이 문제의 해법은 새 의존성을 붙이는 게 아니라, 이미 있는 도구로 한 번 더 렌더해 값을 재는 것이었다. 의존성 하나를 안 늘리면 설치·버전·보안 점검이 전부 줄어든다. 다만 작은 디테일에 드는 비용을 미리 알고 결정해야 한다. 자막이 한 글자씩 찍히는 건 시청자가 “잘 만들었네”라고 느끼는 지점이지만, 정작 개발에서는 폰트 메트릭·인코딩·시간 배분까지 건드리는 일이었다. 이런 항목은 “있으면 좋은 것”이 아니라 별도 작업 단위로 잡아야 일정이 안 밀린다.
사용한 기술
- ffmpeg
drawtext+enable='between(t,a,b)'— 시간 구간별로 다른 조각을 그린다 scale=W:1:flags=area— 세로로 눌러 열 평균 밝기를 만든다. 면적 평균이라 얇은 획도 남는다-f rawvideo+od— 픽셀 바이트를 직접 훑는다perl -CS— UTF-8 문자 단위 자르기. macOSawk의substr은 바이트 기준이라 한글이 깨진다- fontTools — 폰트
cmap을 열어 글리프 존재를 확인
정리
- 가운데 정렬을 유지한 채 글자를 늘리면 반드시 출렁인다. 완성 문장의 왼쪽 x를 먼저 재서 고정해야 타이핑처럼 보인다.
- 필터그래프 안에서 못 구하는 값은 한 번 더 렌더해서 픽셀로 재면 된다.
cropdetect가 안 먹혀도scale=W:1+ 바이트 읽기로 우회할 수 있다. - 장식 폰트는 글리프부터 확인한다. 나눔손글씨 펜에는 가운뎃점이 없고,
drawtext는 그걸 조용히 빈칸으로 그린다.
다음 편에서는 이 영상에 나레이션을 붙인다. 레퍼런스로 삼은 클립의 목소리를 감이 아니라 주파수로 재서 같은 결의 음성을 찾아내는 이야기다.