ffmpeg amix로 합쳤더니 뒤로 갈수록 소리가 커진다
여러 오디오를 amix로 합쳤는데 앞은 안 들리고 뒤는 귀가 아프다. 실측하니 앞뒤 평균 22dB 차이. 원인은 amix의 normalize 기본 동작이고, 해결은 normalize=0 + 2패스 피크 보정이다.
문제
문장별로 합성한 나레이션 21개를 adelay로 시각에 배치하고 amix로 한 트랙에 합쳤다. 들어보니 앞부분은 잘 안 들리는데 뒷부분은 귀가 아팠다.
느낌이 아니라 값으로 확인하려고 8초 구간씩 잘라서 재봤다.
1
2
3
4
for a in 0 8 16 24 32 40; do
  ffmpeg -hide_banner -ss $a -t 8 -i out.mp4 -map 0:a -af volumedetect -f null - 2>&1 \
    | grep -E "mean_volume|max_volume"
done
1
2
3
4
5
6
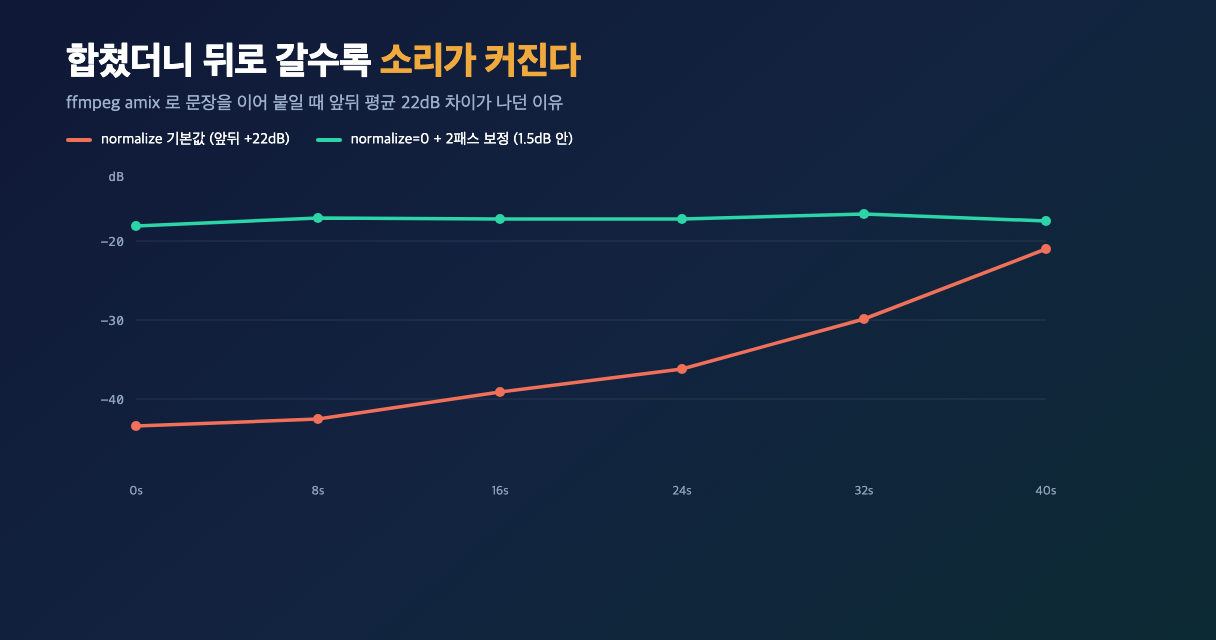
 0~ 8초   평균 -43.4 dB   최대 -26.7 dB
 8~16초   평균 -42.4 dB   최대 -25.7 dB
16~24초   평균 -39.1 dB   최대 -23.2 dB
24~32초   평균 -36.1 dB   최대 -20.2 dB
32~40초   평균 -29.9 dB   최대 -13.1 dB
40~48초   평균 -21.1 dB   최대  -1.5 dB
단조롭게 계속 커진다. 앞뒤로 평균 22dB, 최대 25dB 차이다. 소재는 전부 같은 엔진으로 같은 설정에서 합성한 음성이라 원본 크기 차이는 아니다.
원인
amix 필터의 normalize 옵션이 범인이다. 기본값이 1(켜짐)이고, 이건 “지금 살아 있는 입력 수”로 나눈다.
내가 만든 필터그래프는 이렇게 생겼다.
1
2
3
4
5
[0:a]adelay=1800|1800[a0];
[1:a]adelay=3800|3800[a1];
…
[20:a]adelay=44200|44200[a20];
[a0][a1]…[a20]amix=inputs=21:duration=longest:dropout_transition=0[mix]
각 입력은 “무음 → 문장 → 끝” 구조다. adelay가 앞에 무음을 붙이고, 문장이 끝나면 그 스트림은 EOF에 도달한다.
- 영상 시작 시점: 21개 입력이 전부 살아 있다 → 각 입력이 1/21로 줄어든다
- 중반: 앞쪽 문장들이 하나씩 끝난다 → 나누는 수가 줄어 점점 커진다
- 마지막 문장: 살아 있는 입력이 1개 → 원래 크기 그대로 나온다
그래서 정확히 문장이 끝나는 개수만큼 계단식으로 커진다. 위 실측 곡선이 우상향하는 이유가 이것이다.
dropout_transition을 0으로 둬도 소용없다. 그건 전환을 부드럽게 하는 시간일 뿐, 나누기 자체를 끄지 않는다.
해결 과정
normalize=0
나누기를 끈다.
1
amix=inputs=21:duration=longest:dropout_transition=0:normalize=0
이러면 각 입력이 원래 크기 그대로 더해진다. 내 경우엔 문장들이 시간상 겹치지 않으므로 합산으로 인한 클리핑 걱정도 없다.
입력이 동시에 울리는 상황이라면 얘기가 다르다.
normalize=0으로 그냥 더하면 클리핑이 난다. 그때는 각 입력에volume으로 미리 여유를 주거나, 아래 2패스 보정으로 마지막에 맞춰야 한다.
2패스로 최고점 맞추기
normalize=0만 하면 이번엔 전체 크기가 소재에 좌우된다. 그래서 한 번 뽑아서 최고점을 재고, 목표치와의 차이만큼 보정했다.
1
2
3
4
5
6
7
8
9
10
# 1패스 — 보정 없이 합치기만
ffmpeg -y $INPUTS -filter_complex "$FC" -map "[mix]" -t "$T" -c:a pcm_s16le _raw.wav

# 최고점 측정
MAXV=$(ffmpeg -hide_banner -i _raw.wav -af volumedetect -f null - 2>&1 \
       | sed -n 's/.*max_volume: \(-*[0-9.]*\) dB.*/\1/p')

# 2패스 — 목표 최고점(-1.5dB)에 맞춰 보정
G=$(awk "BEGIN{printf \"%.2f\", -1.5-($MAXV)}")
ffmpeg -y -i _raw.wav -af "volume=${G}dB" -c:a pcm_s16le narration.wav
-1.5dB를 목표로 둔 건 인코딩 과정에서 살짝 넘칠 여지를 남기기 위해서다. 0dB에 딱 붙이면 AAC로 인코딩할 때 클리핑이 날 수 있다.
결과
1
2
3
4
5
6
 0~ 8초   평균 -18.1 dB   최대 -1.8 dB
 8~16초   평균 -17.1 dB   최대 -1.7 dB
16~24초   평균 -17.3 dB   최대 -1.5 dB
24~32초   평균 -17.3 dB   최대 -2.0 dB
32~40초   평균 -16.6 dB   최대 -1.8 dB
40~48초   평균 -17.5 dB   최대 -2.2 dB
앞뒤 차이가 1.5dB 안으로 들어왔다. 22dB에서 1.5dB로.
왜 못 알아챘나
이 버그가 오래 살아남은 이유가 있다.
작업 중에는 파형이나 마지막 부분만 확인하게 된다. 마지막 문장은 살아 있는 입력이 1개라 원래 크기로 나오니, 끝부분만 들으면 “잘 나왔네” 싶다. 앞부분이 조용한 건 “원래 이 문장이 작게 녹음됐나” 하고 넘어가기 쉽다.
구간별로 재보기 전까지는 안 보인다. 그래서 오디오를 합치는 파이프라인에는 구간 음량 측정을 검수 절차에 못 박아두는 게 낫다. 위의 for 루프 한 줄이면 된다.
🧭 기획자·사업자라면 “들어보니 괜찮다”는 검수가 아니다. 사람 귀는 절대 크기에 둔감하고, 특히 앞뒤를 이어 들으면 서서히 커지는 변화를 잘 못 잡는다. 이런 항목은 판정 기준을 숫자로 정해두고(예: 구간 평균 편차 3dB 이내) 자동으로 재게 해야 한다. 그리고 라이브러리 기본값은 누군가의 다른 상황에 맞춰진 값이다.
amix의normalize=1은 “여러 소리를 동시에 섞는” 전형적 용도에는 맞는 기본값이고, 내 용도(시간상 겹치지 않는 문장들)에는 정반대로 작동했다. 기본값을 쓰기로 했다면 그 기본값이 가정하는 상황이 내 상황과 같은지 한 번은 확인해야 한다.
사용한 기술
amix=…:normalize=0— 살아 있는 입력 수로 나누는 동작을 끈다adelay— 각 오디오를 원하는 시각에 배치volumedetect— 평균·최고 음량 측정. 구간을 잘라 반복 측정하면 시간에 따른 변화가 보인다- 2패스 게인 보정 — 재고 → 차이만큼
volume=NdB
정리
amix의normalize는 기본이 켜짐이고, 살아 있는 입력 수로 나눈다. 입력들이 시간차로 끝나면 뒤로 갈수록 커진다.dropout_transition은 이 문제와 무관하다. 꺼야 하는 건normalize다.- 구간별 음량 측정을 검수에 넣어라. 끝부분만 들으면 절대 안 잡힌다.
이 문제는 네이버 클립 자동 제작 시리즈에서 나레이션을 붙이다 만났다. 목소리를 고른 과정은 ③ 레퍼런스에서 내 나레이션 목소리 찾아내기, 컷 길이를 맞춘 과정은 ④ 컷 길이를 말에 맞추기에 있다.