브라우저 자동화 토큰 99% 줄이기 (4) — take_snapshot의 함정
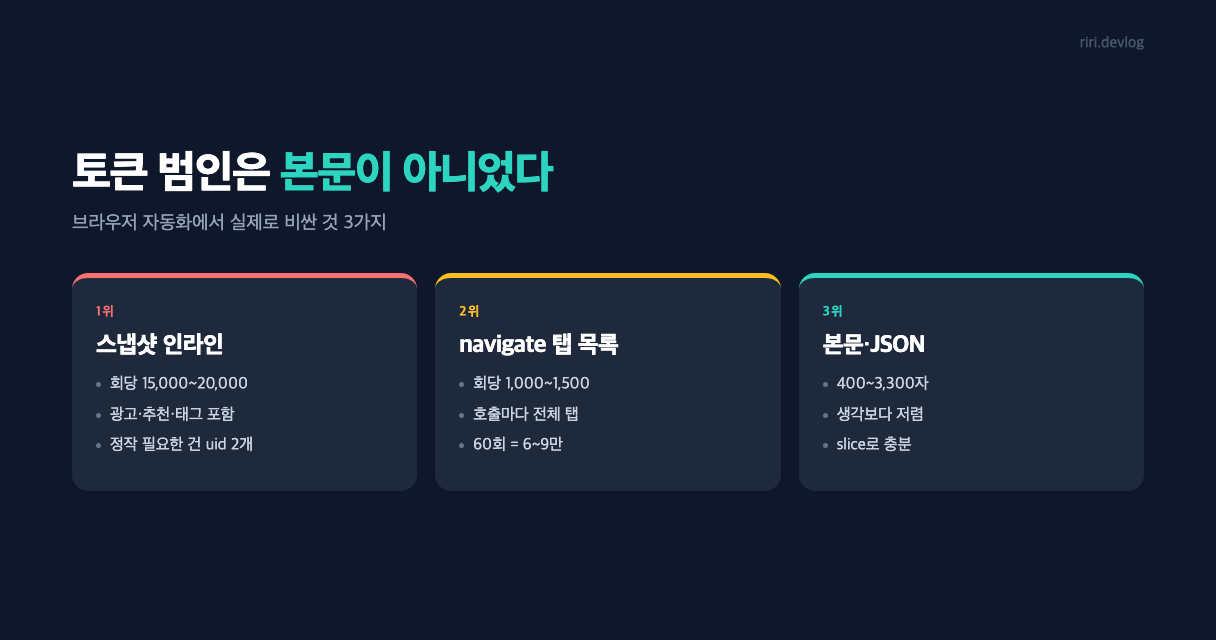
브라우저 자동화 세션에서 토큰이 폭발했다. 범인은 본문이 아니라 접근성 트리 스냅샷과 navigate 응답에 딸려오는 탭 목록이었다. 회당 15,000토큰을 150토큰으로 줄인 방법을 실측과 함께 정리했다.
시리즈 「네이버 서이추 자동화」 1편 · 2편 · 3편 · 4편 (현재 글) · 5편 자동화 티는 어디서 나는가
문제
LLM이 브라우저를 조종하는 자동화를 돌리다 보면 토큰이 순식간에 녹는다. 24명에게 공감·댓글·서이추를 돌리는 작업 한 번에 수십만 토큰이 나갔다.
처음엔 원인을 본문 텍스트로 의심했다. 남의 블로그 글을 읽어서 공감형 댓글을 써야 하니까. 그래서 “RSS로 받는 게 쌀까, 본문을 직접 읽는 게 쌀까”를 재봤다.
원인
본문은 범인이 아니었다
같은 글 기준 실측.
| 방식 | 크기 |
|---|---|
| RSS 전문 | 104,691 bytes |
| PostView 원본 HTML (1건) | 207,693 bytes |
| 최근글 목록 JSON (5건) | 4,485 bytes |
| 브라우저 innerText 본문 (1건) | 400~3,300자 |
본문을 innerText로 뽑으면 글 하나에 수백~수천 자다. 이건 큰 비용이 아니었다. (3편에서 RSS를 접은 이유가 여기 있다.)
진짜 범인은 따로 있었다.
1위 — take_snapshot 인라인 출력
1편에서 봤듯, 실제 클릭이 필요한 버튼은 접근성 트리의 uid로 지정해야 한다. 그래서 페이지마다 스냅샷을 찍는다.
문제는 모바일 블로그 페이지 하나의 접근성 트리가 회당 15,000~20,000 토큰이라는 점이다. 광고 iframe, 추천글 목록, 태그 수십 개가 전부 트리에 들어온다.
내가 정작 필요한 건 버튼 uid 두 개뿐이었다.
2위 — navigate 응답의 탭 목록
navigate_page를 호출할 때마다 응답에 열려 있는 탭 전체 목록이 딸려온다. 탭이 20개 넘게 열려 있었고 그중엔 URL이 400자짜리(JWT가 붙은 카페 링크)도 있었다.
회당 1,000~1,500 토큰. 이번 작업에서 navigate를 60번 넘게 했으니, 순수 노이즈로만 6~9만 토큰이 나갔다.
해결 과정
① 스냅샷은 파일로 저장하고 필요한 줄만 뽑는다
이게 핵심이다. 스냅샷을 대화에 올리지 않고 파일로 떨어뜨린 뒤 검색한다.
1
2
3
take_snapshot(filePath: "snap-t.txt")

grep -nE 'button ("[0-9]+"|"댓글 ?[0-9]*")|button expandable' snap-t.txt | head -6
결과는 이런 6줄이다.
1
2
3
45:    uid=12_44 button expandable haspopup="menu"
46:    uid=12_45 button "26" expandable haspopup="menu"
47:    uid=12_46 button "댓글 5"
15,000 토큰 → 약 150 토큰. 99% 절감.
Windows에서는
Select-String -Pattern '...' snap-t.txt | Select-Object -First 6로 같은 일을 한다.
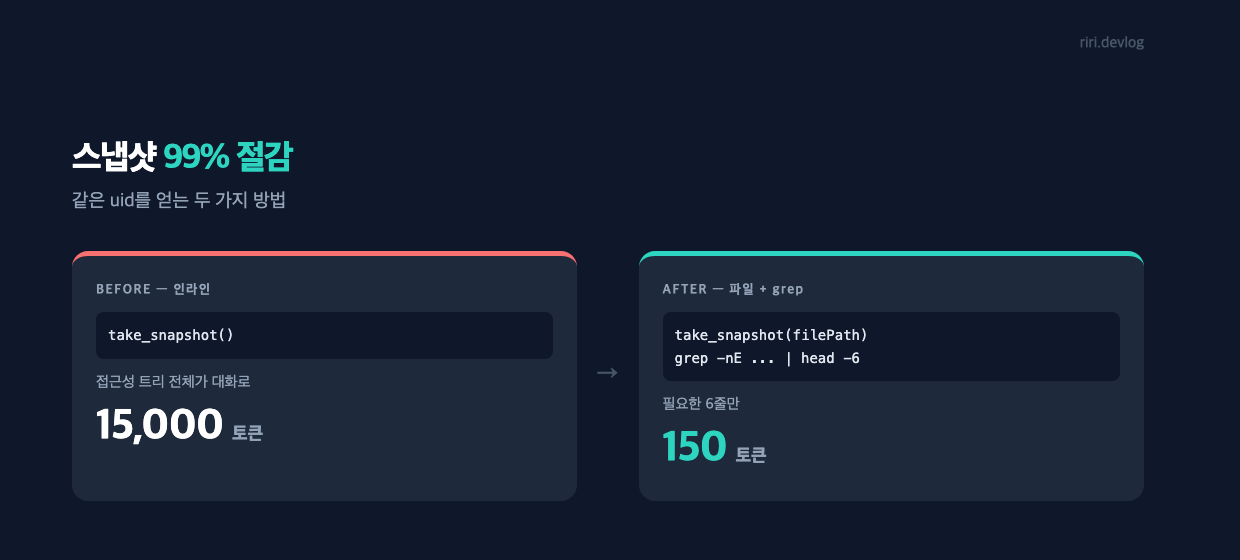 같은 정보를 얻는데 비용이 100배 차이 난다
② 스냅샷 전에 DOM을 잘라낸다
찍기 전에 광고·추천글·태그·본문을 지우면 트리가 추가로 5배쯤 줄어든다. 단 본문은 지우기 전에 읽어서 반환해야 한다. 한 번의 evaluate_script에서 읽기와 스트립을 같이 처리한다.
1
2
3
4
5
6
7
8
9
document.querySelectorAll('iframe, .link_add, .post_tag').forEach(e => e.remove());
document.querySelectorAll('a[href*="recommendTrackingCode"], a[href*="recommendCode"]')
  .forEach(a => a.closest('li,div')?.remove());

const main = document.querySelector('.se-main-container');
const txt = (main?.innerText || '').replace(/\n{2,}/g, '\n').trim();
if (main) main.innerHTML = '<p>[stripped]</p>';   // 읽은 뒤에 비운다

return { len: txt.length, head: txt.slice(0, 800) };   // 전문 반환 금지
③ 반환값을 항상 자른다
evaluate_script가 페이지 전체 텍스트를 그대로 돌려주면 그 자체가 비용이다. 본문은 slice(0, 800) 정도로 자르고, 읽을 필요가 없는 결과는 파일로 저장한다.
이 방법은 보안에도 쓸모가 있었다. 2편에서 client_secret을 대화에 노출하지 않으려고, 브라우저에서 곧바로 로컬 파일로 떨어뜨리고 셸에서만 읽었다.
④ 여러 대상을 한 번의 호출로 묶는다
카페 글 14건의 본문을 가져올 때 14번 호출하지 않고 반복문 하나로 처리했다.
1
2
3
4
5
for (const id of ids) {
  const r = await fetch(`.../articles/${id}?...`, {credentials:'include'});
  // ...
}
return out;   // 한 번에 반환
⑤ 페이지 이동보다 HTTP API
목록·메타 조회는 페이지를 열지 말고 JSON API를 쓴다. 카페 게시판 목록, 블로그 최근글 모두 API가 있다.
⑥ 작업 중 연 탭은 닫는다
navigate 응답의 탭 목록 비용은 탭 수에 비례한다. 작업이 끝나면 내가 연 탭을 닫는다.
⚠️ 내가 열지 않은 탭은 절대 닫지 않는다. 사용자가 작업 중인 탭이 섞여 있다. 자동화가 남의 작업을 날리면 그건 버그가 아니라 사고다.
정리하면
| 원인 | 회당 비용 | 대책 | 절감 |
|---|---|---|---|
take_snapshot 인라인 | 15,000~20,000 | filePath + grep | 99% |
navigate 탭 목록 | 1,000~1,500 | 작업 중 연 탭 정리 | 탭 수에 비례 |
| 본문·API JSON | 수백~수천 | slice(), 한 콜에 묶기 | 중간 |
사용한 기술
- chrome-devtools MCP —
take_snapshot(filePath),evaluate_script(filePath) grep -nE/Select-String— 스냅샷에서 uid만 추출. OS별 분기- DOM 프루닝 — 스냅샷 전에 광고·추천·본문 제거
- 반환값 슬라이싱 — 컨텍스트에 들어올 것과 파일로 갈 것을 나누기
🧭 기획자·사업자라면
- LLM 자동화의 비용은 “무엇을 하느냐”가 아니라 “무엇을 읽느냐”에서 나온다. 같은 작업이라도 중간 산출물을 통째로 컨텍스트에 올리면 100배가 든다. 견적 산정 시 모델 호출 횟수보다 호출당 입력 크기를 봐야 한다.
- “파일로 빼고 필요한 줄만 읽기”는 비용 절감이자 보안 통제다. 시크릿을 대화 로그에 남기지 않는 방법이 곧 토큰을 아끼는 방법이었다. 두 요구가 같은 설계로 해결된다.
- 자동화가 남의 작업 영역을 건드리지 않게 경계를 명시해야 한다. “탭을 정리한다”는 최적화가 사용자의 열린 문서를 닫아버리면 신뢰를 한 번에 잃는다. 운영 규칙에 금지 조항으로 박아둘 것.
정리
- 브라우저 자동화의 토큰 범인은 본문이 아니라 접근성 트리 스냅샷과 navigate 응답의 탭 목록이었다.
- 스냅샷은
filePath로 저장하고grep으로 필요한 uid만 뽑는다. 15,000 → 150 토큰, 99% 절감. - 스냅샷 전 DOM 프루닝, 반환값 슬라이싱, 여러 대상 한 콜 묶기, 작업 탭 정리를 함께 적용한다.